
7 darmowych porad jak zwiększyć widoczność w ChatGPT i innych wyszukiwarkach AI
Na przestrzeni ostatnich 4 lat wyszukiwanie informacji w Internecie zmieniło się diametralnie. Jeszcze do niedawna praktycznie jedynym źródłem informacji była wyszukiwarka Google i jej ranking stron. Dziś coraz popularniejsze stają się rozwiązania bazujące na sztucznej inteligencji takie jak ChatGPT, Google Gemini, Grok, Claude czy Perplexity.
Takie rozwiązania generują bardziej rozbudowane odpowiedzi na pytanie użytkownika korzystając często z wielu źródeł. Wielu właścicieli stron czy biznesów zadaje sobie pytanie – jak sprawić, aby moja strona była częściej cytowana w odpowiedziach AI? Czy klasyczne SEO w Google straciło już na znaczeniu? Na te pytania postaram się odpowiedzieć w poniższym artykule.
Jak działają modele językowe?
Modele językowe (LLM — Large Language Models) to działające na dużą skalę systemy, których działanie sprowadza się tak naprawdę do jednego zadania -> przewidzieć następny token (fragment słowa) na podstawie dotychczasowego kontekstu i wiedzy zakodowanej w wagach modelu podczas treningu.
W wyszukiwaniu informacji w sieci cały proces możemy podzielić na dwa etapy: retrieval (wyszukanie i pobranie odpowiednich źródeł) i generation (wygenerowanie odpowiedzi na ich podstawie). Ten model działania nazywamy RAG — Retrieval-Augmented Generation i jest fundamentem działania wszystkich wyszukiwarek AI, takich jak ChatGPT Search, Perplexity czy Google AI Overviews.
Krok po kroku wygląda to tak:
- Indeksowanie dokumentów (przed zapytaniem) — zanim ktokolwiek zada pytanie, system retrievalu musi „poznać” dokumenty. Przegląda strony internetowe, dzieli ich treść na mniejsze fragmenty (tzw. chunks), a następnie zamienia każdy fragment na embedding — wektor liczbowy, który reprezentuje jego znaczenie. Wektory trafiają do bazy wektorowej, w której można je później szybko wyszukiwać.
- Zapytanie użytkownika — gdy użytkownik zadaje pytanie, trafia ono do tego samego systemu embeddingowego, który zamienia je na wektor liczbowy odpowiadający znaczeniu zapytania.
- Wyszukiwanie semantyczne (retrieval właściwy) — system porównuje wektor pytania z wektorami fragmentów w bazie i znajduje te, których znaczenie jest najbliższe pytaniu. Nie szuka słów — szuka znaczeń. Dlatego fragment, w którym nie pada ani jedno słowo z pytania, ale który merytorycznie na nie odpowiada, może zostać wybrany jako trafniejszy niż fragment zawierający dokładne frazy z zapytania.
- Przekazanie do LLM — top-N najbardziej trafnych fragmentów (zwykle kilka do kilkunastu) trafia do kontekstu modelu językowego razem z pytaniem użytkownika.
- Generowanie odpowiedzi — dopiero teraz do pracy wkracza LLM (ChatGPT, Claude, Gemini). Na podstawie pytania i dostarczonych fragmentów generuje odpowiedź, często wraz z cytowaniami źródeł.
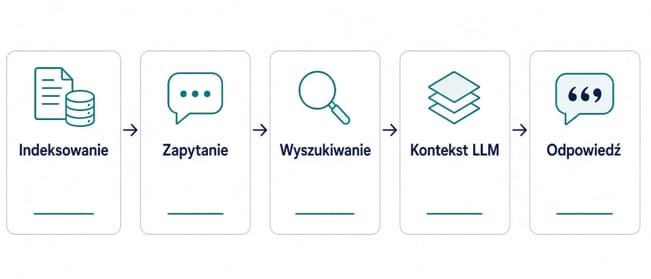
Kluczowe rozróżnienie: retrieval (wyszukanie źródeł) i generation (napisanie odpowiedzi) wykonują dwa różne systemy. Pierwszy to silnik wyszukiwania oparty na embeddingach i bazie wektorowej. Drugi to właściwy model językowy. LLM sam z siebie nie „przeszukuje internetu” — robi to system retrievalu, który dopiero podaje mu gotowe materiały.
Kluczowe rozróżnienie: retrieval (wyszukanie źródeł) i generation (napisanie odpowiedzi) wykonują dwa różne systemy.
Wyszukanie źródeł
Silnik wyszukiwania oparty na embeddingach i bazie wektorowej. Jego zadanie: znaleźć fragmenty tekstu najbliższe pytaniu użytkownika.
Napisanie odpowiedzi
Właściwy model językowy (LLM). Dostaje gotowe materiały z retrievalu i składa z nich spójną odpowiedź w naturalnym języku.
Jak to zmienia optykę SEO? W klasycznym SEO walczyliśmy o jak najwyższą pozycję w rankingu Google. W wyszukiwarkach AI walczymy o to, by nasza treść — w postaci konkretnego, dobrze wyodrębnionego fragmentu — została wybrana przez system retrievalu jako jedno ze źródeł, z których model zbuduje odpowiedź. Strona musi być nie tyle „wysoko pozycjonowana”, co łatwa do pobrania i zacytowania.
Jakie są obecnie najpopularniejsze modele AI w Polsce?
ChatGPT (OpenAI) – z moich obserwacji wynika, że to obecnie najpopularniejszy model AI w Polsce. Mnóstwo moich znajomych myśląc o rozwiązaniach AI ma na myśli właśnie popularnego Chata od OpenAI. Jest to model z którego najchętniej korzysta tzw. ulica, czyli mniej zaawansowani użytkownicy. Dzieje się tak przede wszystkim dlatego, że był jednym z pierwszych modeli, jakie mówiąc kolokwialnie „dowoziły oczekiwane rezultaty”, przez co utarł się w pamięci użytkowników, jako zaufane źródło wiedzy.
Claude (Anthropic) – model który cieszy się największą popularnością wśród bardziej zaawansowanych użytkowników – programistów czy osób korzystających z niego w pracy. Świetnie radzi sobie z kodowaniem, nie gubi wątków, w mojej opinii jest bardziej precyzyjny niż ChatGPT. Jego modele takie jak Opus świetnie radzą sobie z tekstami w języku polskim. Przyznaję, że to mój obecny faworyt, jeśli chodzi o rozwiązania AI i korzystam z niego na co dzień.
Gemini (Google) – model wyszukiwarki Google mocno zintegrowany z całym systemem rozwiązań firmy. Często wybierany do pracy z dużymi plikami PDF, multimediami oraz analizą danych. Model zintegrowany jest z narzędziami takimi jak wyszukiwarka, poczta czy dysk Google.
7 darmowych porad jak zwiększyć widoczność strony w ChatGTP i innych modelach AI
Poznaj 7 rad dzięki którym Twoja strona internetowa będzie chętniej cytowana wyszukiwarkach AI.
1. Pozwól robotom AI na indeksowania Twojej strony
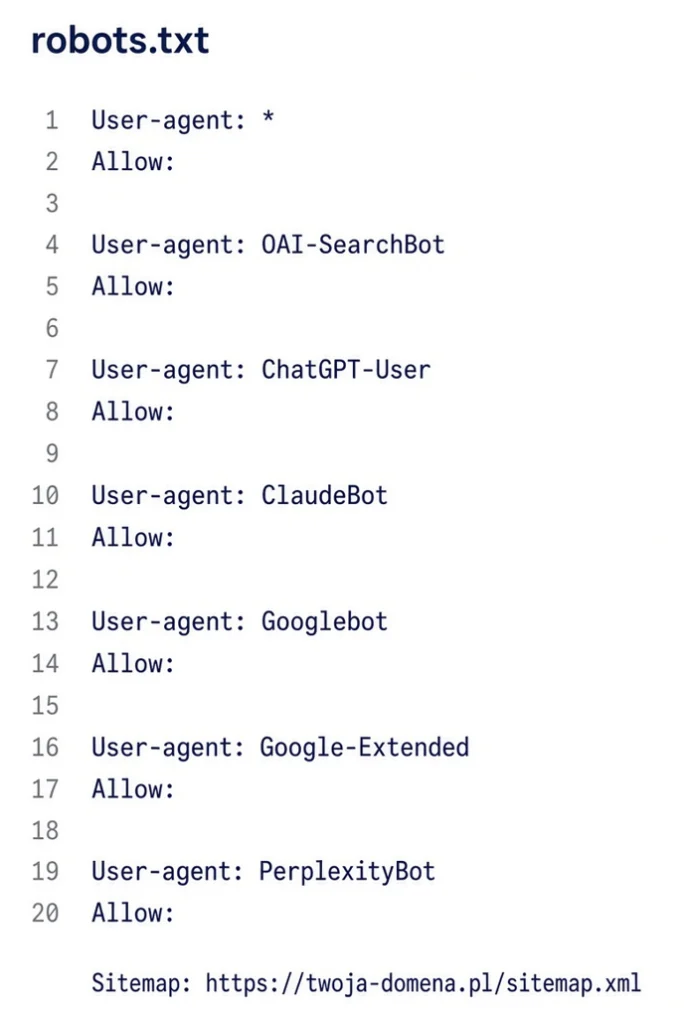
Fundamentalnym czynnikiem na który musisz zwrócić uwagę, aby Twoja marka była cytowana w odpowiedziach modeli AI jest dostępność: boty musza móc wejść na Twoją stronę i pobrać jej zawartość. Brzmi jak oczywistość, ale w praktyce to właśnie na tym etapie wiele witryn traci całą widoczność w AI, często nieświadomie — bo domyślne konfiguracje serwerów, CDN-ów i wtyczek bezpieczeństwa coraz częściej blokują crawlerów AI „na wszelki wypadek”. Jednym z najczęstszych problemów jest blokowanie robotów w pliku robots.txt.
Jak zweryfikować czy nasza strona nie blokuje robotów AI?
- Sprawdź zawartość pliku robots.txt pod kątem tego czy nie występuje w nim dyrektywa Disallow: / dla botów AI tj. OAI-SearchBot, ChatGPT-User, ClaudeBot czy Googlebot.
- Sprawdź czy Twój serwer lub ustawienia zapór w CMS nie blokują dostępu robotom.
- Blokowanie po adresach IP – sprawdź czy adresy IP na jakich operują roboty AI nie są blokowane przez Twoją sieć.
- Unikaj dyrektyw <meta name=”robots” content=”noai, noimageai”> w sekcji <head> strony, ponieważ część robotów go respektuje.
2. Pisz unikalne treści dla użytkownika, rozwiązuj jego problemy
Roboty kochają unikalne treści które odpowiadają na potrzeby użytkownika. Obecnie, dzięki wykorzystaniu AI możemy generować setki artykułów na wybrane tematy w ciągu jednej chwili. Google, ChatGPT i inne wyszukiwarki cenią eksperckość i unikalność tekstu!
Zbadaj jakie potrzeby mają użytkownicy w Twojej niszy i napisz dla nich ekspercki artykuł bazujący na Twojej wiedzy i doświadczeniu. Nie bój się cytować innych wiarygodnych źródeł – to wzmacnia Twoją wiarygodność o której napiszę jeszcze w dalszej części artykułu.
Twórz rankingi, tabele (koniecznie w html), porównania, badania. Odróżniaj swoją treść od konkurencji.
I najważniejsze – odpowiadaj na potrzeby użytkowników. AI lubi formy, które łatwo może przetworzyć (wpływ na koszt Retrieval), a nie „rozmazane” długie fragmenty, z których ciężko wyłapać odpowiedź.
Stosuj schemat: pytanie w nagłówku -> precyzyjna odpowiedź w pierwszym akapicie. Przykład:
Pytanie: Kim jest Kordian Minkina?
Odpowiedź: Kordian Minkina to specjalista SEO z Częstochowy.
3. Zadbaj o fundamenty związane z optymalizacją strony
Tradycyjne techniczne SEO ciągle ma kluczowe znaczenie. Czynniki wpływające na widoczność stron mają również przełożenie na SEO w AI. Powinieneś zadbać o:
- Strukturę podstron – logiczny podział serwisu na sekcje, kategorie, wpisy czy podstrony ofertowe. Budowanie klastrów tematycznych wokół danego tematu – topical authority.
- Meta tagi takie jak tytuł (title) czy opis strony (desc) wyświetlają się w wynikach Google i są pierwszym „stykiem” użytkownika ze stroną. Często na ich podstawie użytkownik podejmuje decyzje czy wejść na daną stronę.
- Mapa strony – ułatwia indeksowanie.
- Optymalizacja pod kątem szybkości ładowania – jeśli strona ładuje się wolno i użytkownik musi czekać na jej zawartość, to uwaga! Prawdopodobnie sobie odpuści 😉
- Bezpieczeństwo – zadbaj o aktualny certyfikat SSL i pilnuj, aby na Twojej stronie nie było wirusów.
- UX – w mojej opinii mocno powiązany z SEO. Słaba strona potrafi uwalić nawet najlepszy content i linki. Google bierze pod uwagę czynniki behawioralne – czyli to jak użytkownik zachowuje się na stronie, w co klika, ile czasu na niej przebywa. Jeśli Twoja strona nie dowozi, a konkurencji tak, to Twoje wyniki idą w dół.
- Linkowanie wewnętrzne – przemyślana struktura linków wewnętrznych i powiązań między poszczególnymi artykułami w obrębie serwisu to ciągle jeden z fundamentów budowania widoczności.
4. Zadbaj o E-E-A-T
E-E-A-T to akronim od Experience, Expertise, Authoritativeness, Trustworthiness — czyli doświadczenie, ekspertyza, autorytet i wiarygodność. Pierwotnie Google wprowadził tę koncepcję w swoich Search Quality Rater Guidelines jako zestaw kryteriów, którymi pracownicy Google oceniają jakość stron.
Z czasem zasady te stały się fundamentem rankingu dla tematów YMYL (Your Money or Your Life — zdrowie, finanse, prawo), a od 2022 roku do klasycznego E-A-T dodano „Experience” — podkreślając wagę realnego, osobistego doświadczenia autora.
W erze AI SEO E-E-A-T przestało być tylko wytyczną dla Google — stało się podstawowym filtrem, przez który modele językowe decydują, komu zaufać przy budowaniu odpowiedzi.
- ChatGPT
- Perplexity
- Claude
- Google AI Overviews
Nie cytują stron losowo. Wybierają źródła, które ich systemy retrievalu i modele oceny uznają za wiarygodne eksperckie reprezentacje konkretnej encji.
Dlaczego E-E-A-T działa inaczej w świecie AI
W klasycznym SEO E-E-A-T wpływał na pozycje w SERP-ie. W AI SEO działa na dwóch dodatkowych poziomach:
Na etapie treningu. Modele uczą się, które źródła „zazwyczaj mają rację” o danym temacie. Jeśli Twoja marka regularnie pojawia się w kontekście tematu X obok innych autorytatywnych źródeł — model buduje asocjację „ten temat → te źródła”. Nawet bez retrievalu będzie wtedy skłonniejszy wymienić Twoją markę przy pytaniu z tej dziedziny.
Na etapie retrievalu. Gdy LLM pobiera źródła do odpowiedzi w czasie rzeczywistym, systemy wyszukiwania (Bing dla ChatGPT, własny indeks Perplexity, Google dla Gemini) priorytetyzują strony z silnymi sygnałami autorytetu. Nawet idealnie zoptymalizowana strona bez tych sygnałów będzie przegrywać z gorzej napisaną, ale „cytowalną” treścią z silnej domeny.
Rozbijmy to na składniki
Experience — doświadczenie
Najmłodszy element E-E-A-T, dodany w grudniu 2022. Chodzi o to, czy autor rzeczywiście zrobił to, o czym pisze. Recenzja aparatu napisana przez kogoś, kto nim robił zdjęcia, bije teoretyczny przegląd specyfikacji. Przewodnik po kuchni w Lizbonie od kogoś, kto tam był, bije artykuł napisany zza biurka.
W praktyce na stronie:
- First-person storytelling — „testowałem”, „pracowałem z klientem X”, „wdrożyliśmy w 2024”
- Oryginalne zdjęcia z realizacji (nie stocki)
- Case studies z konkretnymi liczbami — nie „zwiększyliśmy sprzedaż”, tylko „zwiększyliśmy ROAS z 3.2 do 5.8 w ciągu 4 miesięcy”
- Daty, miejsca, nazwy klientów (za zgodą) — „projekt dla klienta z branży X, zrealizowany w Q2 2025”
- Materiały „zza kulis” — screeny z paneli Google Ads, konkretne konfiguracje, błędy, z którymi się zmierzyliście
Dla modelu AI to są sygnały: „ta strona pisze z doświadczenia, nie z research’u na innych blogach”.
Expertise — ekspertyza
Czy autor ma wiedzę w danym temacie? Formalnie i merytorycznie.
Sygnały:
- Jasno pokazany autor artykułu z biografią, nie „admin” ani brak podpisu. Sprawdź jak to wygląda na moim blogu + na podstronie O mnie.
- Kwalifikacje — wykształcenie, certyfikaty, doświadczenie zawodowe
- Powiązania z organizacjami — „Google Partner”, „certyfikowany specjalista X”, członkostwo w izbach branżowych
- Spójna specjalizacja — autor, który pisze o SEO, Google Ads i WordPressie buduje profil eksperta cyfrowego; ten sam autor piszący dodatkowo o kryptowalutach, dietach i polityce rozmywa swoją ekspertyzę
- Topical authority strony — cała witryna skupiona na jednej dziedzinie, nie „wszystko dla wszystkich”
W kontekście AI szczególnie ważne są dwa mechanizmy:
- Author entity — autor jako encja z własnym profilem (strona /o-mnie, Wikidata jeśli to możliwe, LinkedIn, profile branżowe), powiązana ze stroną przez Person → author w JSON-LD. Pisałem o tym wyżej jeśli chodzi o wykorzystanie danych strukturalnych.
- Topic clustering — treści na stronie tworzą spójny klaster tematyczny, nie przypadkowy miszmasz
Authoritativeness — autorytet
Czy inni uznają Cię za eksperta? To E-E-A-T na poziomie reputacji w sieci, nie samej strony.
Sygnały:
- Backlinki z autorytatywnych źródeł branżowych — nie masowo, ale jakościowo,
- Cytowania w artykułach prasowych, branżowych portalach, podcastach — nawet bez linku, brand searching to również bardzo ważny sygnał. Ktoś szuka Twojej marki = sygnał dla Google.
- Występy jako prelegent, panelista, autor gościnny — i strony, które to dokumentują,
- Profile w Wikidata, DBpedia, Wikipedii (dla większych marek),
- Spójne NAP i opis marki we wszystkich zewnętrznych serwisach,
- Google Knowledge Panel — jeśli udało się go uzyskać, to mocny sygnał dla modeli, że marka jest „znaną encją”,
- Opinie, oceny, reviewy — Google Business, Trustpilot, branżowe serwisy.
Mechanizm w AI: modele uczą się autorytetu z gęstości i jakości wzmianek. Marka wspomniana 200 razy w kontekście „najlepszy freelancer SEO w Polsce” na różnych blogach, forach i w artykułach — nawet bez bezpośrednich linków — zostanie przez model uznana za autorytet w tym temacie. To tzw. unlinked brand mentions, które w erze LLM są co najmniej tak samo ważne jak klasyczne linki.
Trustworthiness — wiarygodność
Najważniejszy element — Google wyraźnie zaznacza, że Trust jest centralnym punktem E-E-A-T. Bez wiarygodności reszta nie ma znaczenia.
Sygnały:
- HTTPS, poprawny certyfikat SSL — minimum podstawowe
- Jasne dane kontaktowe — adres, telefon, NIP/KRS, formularz kontaktowy, prawdziwe osoby za firmą
- Strony „O nas”, „Zespół”, „Kontakt” — kompletne, z realnymi informacjami
- Polityka prywatności, regulamin, cookies, RODO — profesjonalnie przygotowane
- Transparentność autorstwa — kto napisał, kiedy, kiedy zaktualizowano
- Źródła cytowane w treści — linki do oryginalnych badań, dokumentów, oficjalnych stron
- Brak clickbaitu, wprowadzających tytułów, agresywnych reklam
- Spójność faktów — to, co piszesz na stronie, zgadza się z tym, co w Google Business, LinkedIn, KRS
- Realne zdjęcia zespołu, siedziby, biura — nie stocki
- Historia działalności — od kiedy istniejecie, ile zrealizowanych projektów
Dla modeli AI „trust” to w dużej mierze weryfikowalność. Jeśli fakty podane na stronie da się potwierdzić w innych zaufanych źródłach (KRS, Google Business, LinkedIn, Wikidata), model buduje „pewność” encji. Niespójność osłabia tę pewność i obniża szansę cytowania.
5. Encje w AI SEO i powiązanie ze Schema.org
Modele AI nie myślą słowami kluczowymi — myślą encjami. Encja to jednoznacznie zidentyfikowany byt (osoba, firma, miejsce, usługa, produkt), który istnieje niezależnie od tego, jakimi słowami ktoś go opisze. „Kordian Minkina”, „freelancer SEO z Częstochowy” i „Kordian od SEO” to dla modelu ta sama encja, pod warunkiem że potrafi je ze sobą powiązać.
To właśnie dlatego Google od czasu wprowadzenia Knowledge Graph w 2012 roku, a potem aktualizacji Hummingbird i modeli BERT, MUM oraz Gemini, odszedł od dopasowywania ciągów znaków na rzecz rozumienia bytów i relacji między nimi. ChatGPT, Perplexity, Claude i Google AI Overviews działają na tej samej zasadzie — zanim cokolwiek Ci odpowiedzą, muszą wiedzieć, o jakiej encji mówisz i co o niej wiedzą zaufane źródła.
Konsekwencja praktyczna: jeśli Twoja marka, osoba czy firma nie jest dla modelu rozpoznawalną, jednoznaczną encją — nie pojawisz się w odpowiedzi, choćby strona była idealnie zoptymalizowana klasycznie.
Jak Schema.org deklaruje encję
Schema.org to wspólny słownik typów i właściwości (Organization, Person, LocalBusiness, Product, Service, Article, FAQPage itd.) utrzymywany przez Google, Microsoft, Yahoo i Yandex. Dane strukturalne w formacie JSON-LD to najprostszy, formalny sposób, by powiedzieć modelom: „oto moja encja, oto jej atrybuty, oto z czym jest powiązana”.
Mechanizm opiera się na czterech elementach:
-
Deklaracja typu encji
Np.
@type: LocalBusinessz nazwą, adresem, telefonem, zakresem usług. -
Jednoznaczna identyfikacja
Stabilne
@idjako URI encji — jedna tożsamość, do której wszystko się podpina. -
Powiązania zewnętrzne
Właściwość
sameAsz linkami do Google Business, LinkedIn, Wikidata, KRS, oficjalnych profili branżowych — mówi modelowi „to ta sama encja co tam”. -
Relacje między encjami
founderemployeebrandareaServedknowsAboutaboutprovider— tworzą graf, który modele czytają jak sieć powiązań.
Dobre dane strukturalne nie „tworzą” encji — ona i tak istnieje w świecie — ale ułatwiają maszynom jej jednoznaczne rozpoznanie i wpięcie do istniejącego grafu wiedzy.
Minimum praktyczne dla strony klienta
- Organization lub właściwy podtyp LocalBusiness (np. Dentist, Physician, AutoRepair, Plumber) z pełnym NAP, url, logo, image, priceRange, openingHoursSpecification, areaServed
- sameAs z linkami do: Google Business, Facebook, LinkedIn, Wikidata (jeśli istnieje), rejestru branżowego
- Dla ekspertów stojących za marką — Person z jobTitle, worksFor, alumniOf, knowsAbout
- Service lub OfferCatalog opisujący faktyczne usługi, powiązany przez provider z organizacją
- Dla treści — Article i FAQPage z about i mentions wskazującymi na konkretne encje
Do poprawności wdrożenia danych strukturalnych na swojej stronie możesz wykorzystać darmowe narzędzie od Google https://developers.google.com/search/docs/appearance/structured-data?hl=pl.
Do tego — spójne NAP (czytaj czym są wizytówki NAP) we wszystkich zewnętrznych źródłach, obecność w zaufanych katalogach i, jeśli skala pozwala, wpis w Wikidata. To właśnie z tych sygnałów modele AI budują pewność, że encja istnieje, jest jednoznaczna i wiarygodna.
6. Modułowość i multimodalność tekstu
Modele AI mają zdolność multimodalnego przetwarzania i łączenia różnych typów danych wejściowych i wyjściowych. Brzmi nieco skomplikowanie, ale w praktyce jest to proces którego dokonujemy na co dzień, poprzez łączenie danych z różnych źródeł np. tekstu, wideo, grafiki w jedną całość.
Przykłady modalności:
- tekst
- obraz (zdjęcia, grafika, screenshoty)
- dźwięk (mowa, muzyka)
- wideo
- kod lub dane strukturalne
Model multimodalny (np. GPT-4o, Gemini, Claude) potrafi „przeczytać” screenshot strony i opisać go słowami, albo z opisu tekstowego wygenerować obraz. „Multimodalność tekstu” w tym ujęciu oznacza, że tekst jest jedną z modalności — osadzony w tej samej przestrzeni wektorowej co obrazy czy dźwięk, dzięki czemu model rozumie powiązania między nimi.
- Google MUM
- Gemini
- AI Overviews
Potrafią łączyć sygnały z tekstu strony, alt-textów, obrazów produktowych, nagrań wideo i transkrypcji — czyta cały kontekst, nie tylko akapity.
Dla SEO ma to konkretne znaczenie:
-
Alt-texty, podpisy, nazwy plików zyskują na wadze — nie są już tylko dla dostępności, model czyta je jako pełnoprawny sygnał semantyczny.
-
Wideo z transkrypcją oraz obrazy opisane w kontekście encji wzmacniają temat strony — każda modalność dokłada swoją warstwę tego samego przekazu.
-
Model może „zobaczyć” produkt na zdjęciu i powiązać go z opisem tekstowym. Rozbieżność między nimi osłabia sygnał — nazwa w tekście musi zgadzać się z tym, co widać na zdjęciu i co jest w alt-text.
Natomiast w kontekście modułowości tekstu mam tutaj na myśli fakt, że LLM-y dzielą teksty na mniejsze fragmenty i dobierają tylko te sekcje tekstu, które najlepiej odpowiadają na zapytanie użytkownika. Dlatego:
- Podziel artykuł na sekcje, najlepiej w formie nagłówków.
- Zadawaj pytanie na początku sekcji i udzielaj odpowiedzi w pierwszym akapicie. Tak, żeby model mógł w łatwy sposób pobrać odpowiedź na zadane pytanie.
- Dodaj segmenty multimodalne, które pozwolą modelowi jeszcze lepiej powiązać i ustrukturyzować odpowiedź.
7. Opinie, cytowalność, linki zewnętrzne, budowanie autorytetu, media społecznościowe
- Zadbaj o opinie o swojej firmie – modele AI kochają powoływać się na wszelkiego rodzaju opinie z autorytatywnych źródeł takich jak profil firmy w Google, Ceneo czy Opineo.
- Rankingi firm, recenzje, porównania – kolejny ważny element. AI często powołują się na rankingi firm, recenzje użytkowników czy porównania.
- Obecność na forach internetowych – cytowanie Twojej firmy w serwisach takich jak Quora, Reddit czy inne fora internetowe (najlepiej branżowe) wzmacnia wiarygodność marki.
- PR – buduj wizerunek eksperta, lidera, opiniotwórcy na zewnętrznych serwisach internetowych. Udzielaj się na grupach Facebookowych.
- Buduj swoje media społecznościowe – obecnie pozycjonowanie nie skupia się wyłącznie na SEO i linkach. To kreacja marki, brandu, persony i strony w jedną spójną całość.
Czy klasyczne SEO dalej ma znaczenie?
W mojej opinii zdecydowanie tak – klasyczne SEO ma nadal fundamentalne znaczenie w wynikach Google czy wyszukiwarkach AI. SEO jednak ewoluowało, jak to ma w swojej zwyczaju. To ciągły proces i ciągła zmiana. Czynnik który kiedyś miał fundamentalne znaczenie i wagę dla algorytmu, dziś jest jednym z wielu determinujących widoczność strony.
Fundamenty jednak pozostają stałe – musisz mieć dobra stronę internetową, podzieloną na właściwe i tematyczne sekcje, musisz mieć połapane kwestie techniczne i szybkość ładowania strony. Twój content musi być świeży, aktualny i precyzyjny.
Twoja firmy lub marka dalej musi być widoczna na zewnętrznych stronach, cytowana, musisz budować wizerunek i eksperckość w swojej niszy.
Podsumowanie
SEO w erze modeli językowych nie umarło — przeszło głębszą transformację. Google, ChatGPT, Claude, Perplexity i Gemini nie szukają już stron pasujących słowem w słowo do zapytania. Szukają encji, którym ufają, i fragmentów treści, które da się łatwo pobrać i zacytować. Cała strategia widoczności w AI sprowadza się dziś do odpowiedzi na jedno pytanie: czy moja marka jest dla modelu rozpoznawalną, wiarygodną encją w swojej dziedzinie — i czy moja treść jest zbudowana tak, by model mógł ją sprawnie pobrać i wykorzystać?
Z omówionych w artykule siedmiu obszarów wyłania się spójna strategia działania:
- Dostępność techniczna to fundament — jeśli boty AI nie wejdą na stronę, cała reszta nie ma znaczenia. Audyt robots.txt, firewalli i renderowania to pierwszy krok, nie ostatni.
- Unikalna, ekspercka treść nadal wygrywa — ale musi być pisana w strukturze, którą modele łatwo przetwarzają: pytanie w nagłówku, odpowiedź w pierwszym akapicie, tabele i porównania zamiast rozwlekłej narracji.
- Techniczne SEO nie zniknęło — struktura serwisu, szybkość, bezpieczeństwo, UX i linkowanie wewnętrzne to te same filary, co w 2015 roku, tylko dziś działają również na rzecz retrievalu.
- E-E-A-T stał się głównym filtrem zaufania — doświadczenie, ekspertyza, autorytet i wiarygodność decydują o tym, czy model w ogóle rozważy Twoją markę jako źródło.
- Encje i Schema.org to język, którym mówisz modelom, kim jesteś — bez spójnej, strukturalnie zadeklarowanej encji marka pozostaje dla LLM-ów „jedną z wielu”.
- Modułowość i multimodalność zmieniają sposób pisania — treść musi być łatwa do rozbicia na samonośne fragmenty i wspierana obrazami, wideo oraz transkrypcjami powiązanymi z encjami.
- Autorytet poza stroną — opinie, cytowania, obecność na forach, PR i media społecznościowe — buduje gęstość wzmianek, z której modele uczą się, że jesteś ekspertem w swojej niszy.
Najważniejszy wniosek: klasyczne SEO się nie skończyło — ewoluowało. Fundamenty pozostają te same, ale dochodzi do nich nowa warstwa pracy nad widocznością encji, cytowalnością treści i spójnością obecności marki w całym cyfrowym ekosystemie. Zwycięzcami w erze AI będą ci, którzy przestaną myśleć wyłącznie o pozycjach w SERP-ie, a zaczną budować markę jako jednoznaczne, wiarygodne źródło, do którego modele chętnie wracają — zarówno w treningu, jak i w retrievalu.
Jeśli dopiero zaczynasz, zrób to po kolei: odblokuj boty, uporządkuj dane strukturalne i encje, zbuduj autorytet autora, pisz treści, które same proszą się o zacytowanie — i pamiętaj, że to proces, nie jednorazowy projekt. SEO w AI, podobnie jak klasyczne SEO, nagradza konsekwencję bardziej niż chwilowe sprinty.


